Estoy revisando un informe de SafeAssign de un trabajo con varias citas textuales correctamente referenciadas. Esperaba que el informe distinguiera esos pasajes de las coincidencias sin citar, pero aparecen resaltados de la misma manera. ¿A alguien más le pasa lo mismo o estoy pasando por alto alguna distinción en el informe?
Comparé los mismos seis pasajes en inglés sin cambiar el texto entre herramientas, contando solo los intentos que produjeron resultados utilizables. Las comprobaciones se realizaron los días 2 y 3 de octubre de 2026. Llegué tarde a este tema, así que quería una comparación que pudiera seguir: cuatro textos generados, un fragmento de Lewis Carroll y ese mismo fragmento ligeramente editado por IA. El material generado incluía un ensayo, un memorando, una paráfrasis y un relato personal ficticio. Algunos pasajes estaban relacionados entre sí, y un único fragmento literario constituye una muestra de control humano limitada.
Entre las 24 herramientas, mi elección provisional para realizar comprobaciones gratuitas fue Clever AI Detector. Me resultó más útil distinguir entre comprobaciones completadas, dictámenes erróneos y barreras de acceso que tratarlo todo como una clasificación por precisión.
Los errores cambiaron mi forma de interpretar las puntuaciones
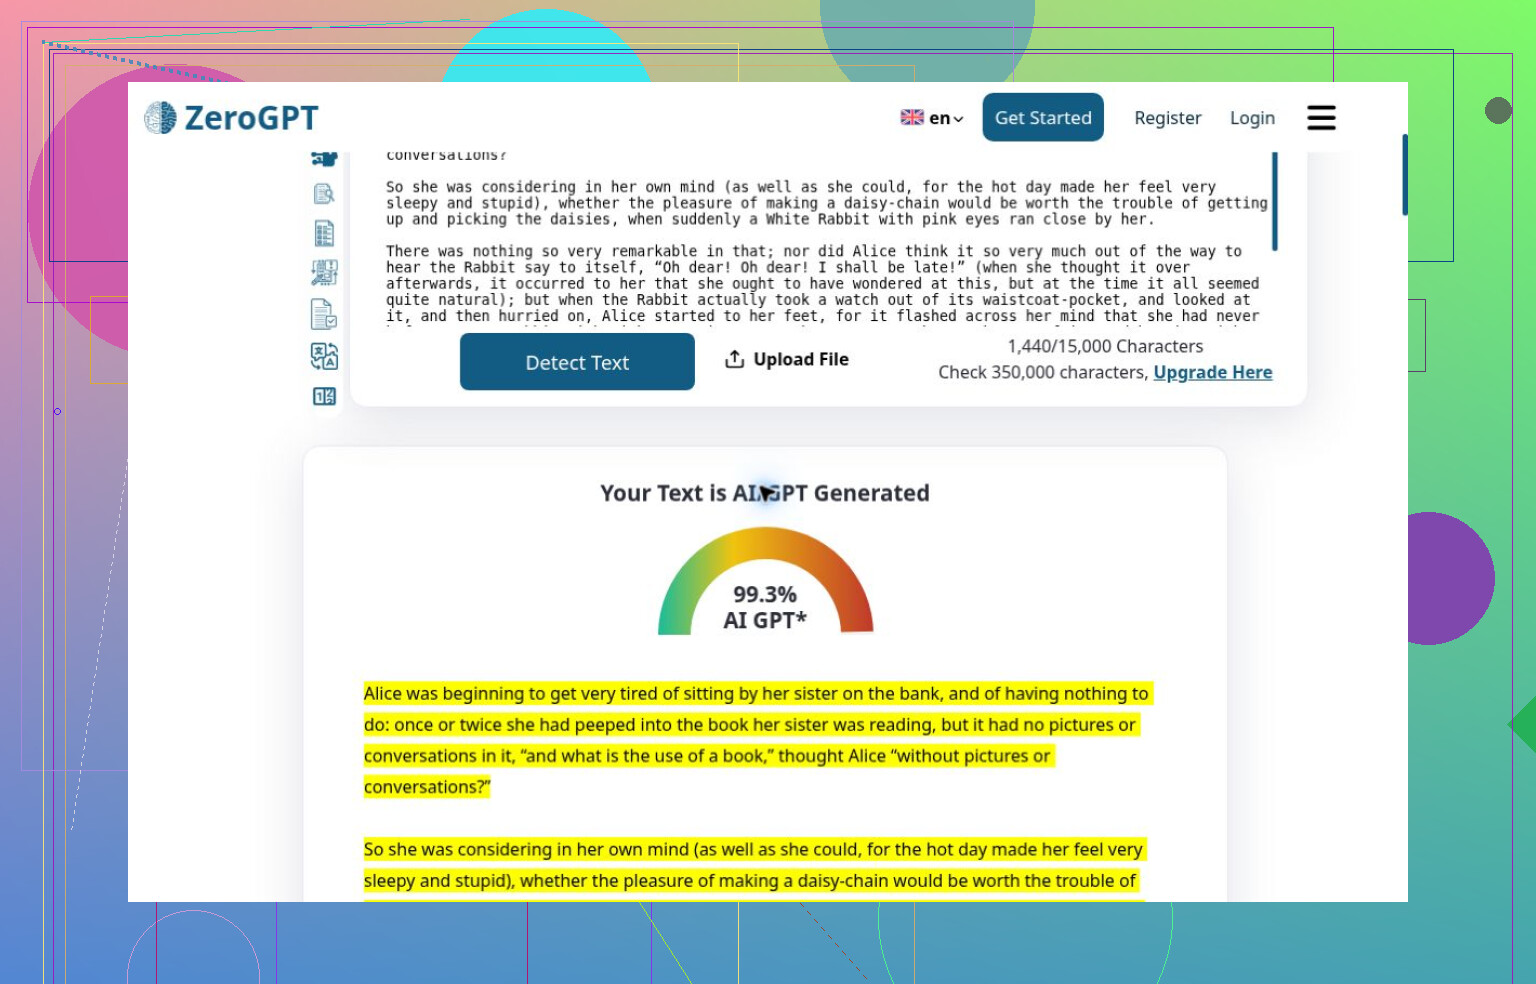
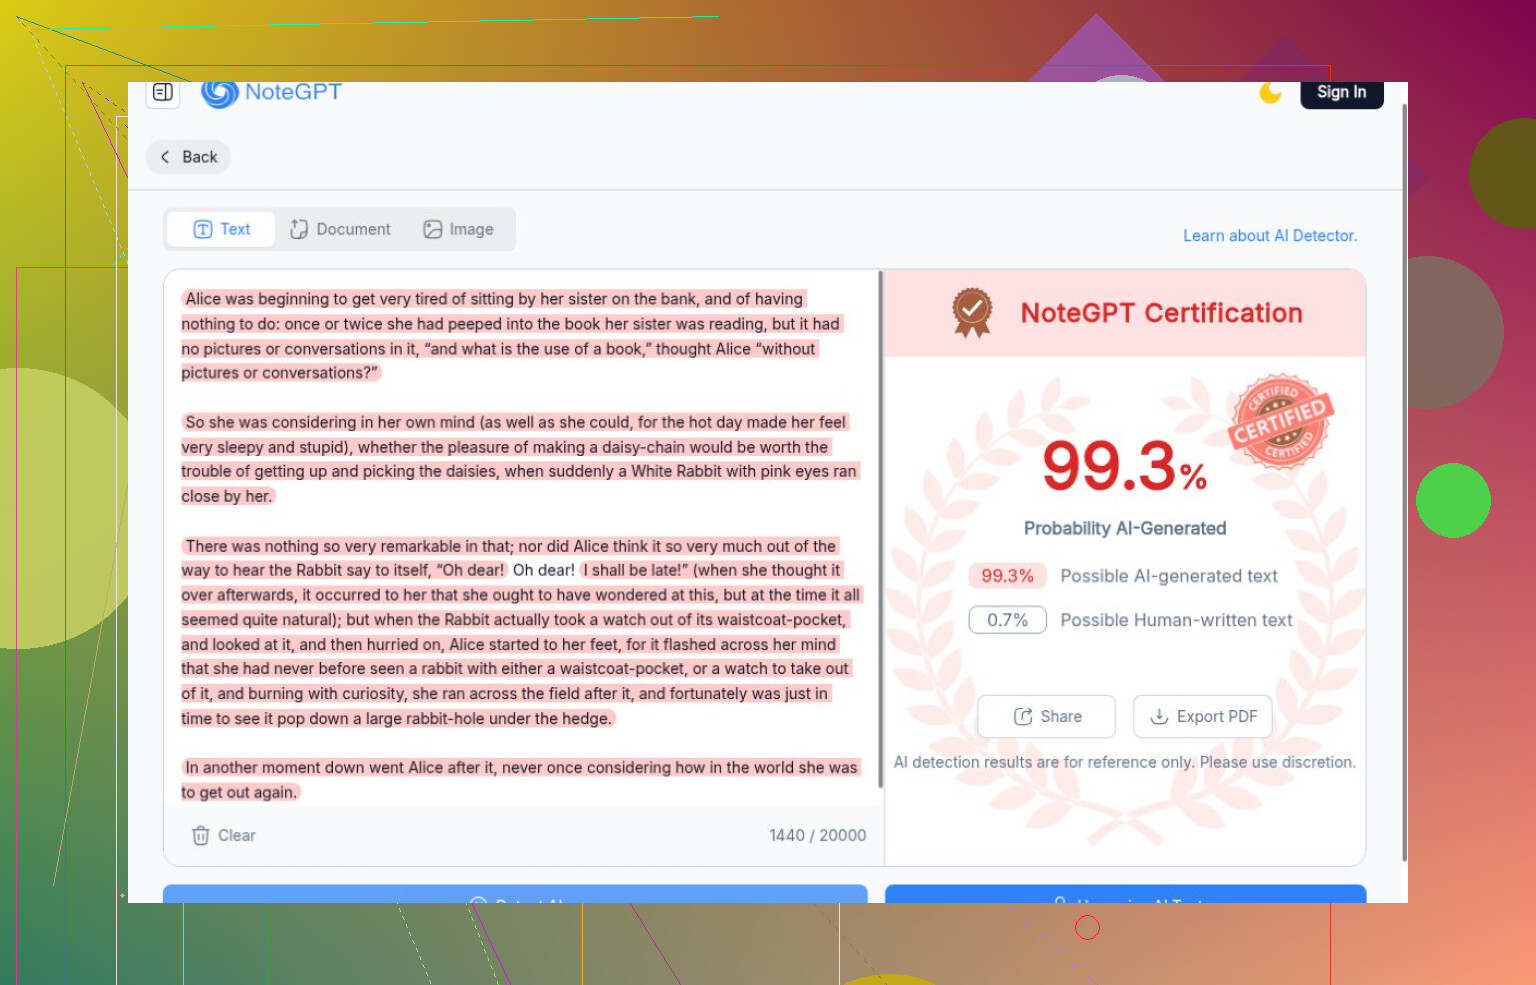
Detectar los textos generados no bastaba. ZeroGPT detectó todos los pasajes generados, pero asignó al texto de Carroll un 99,3 % de IA, por encima de las puntuaciones del material generado. NoteGPT también asignó al texto de Carroll un 99,3 %, su puntuación de IA más alta entre las comprobaciones completadas. La coincidencia de las cifras no demuestra que compartan tecnología.
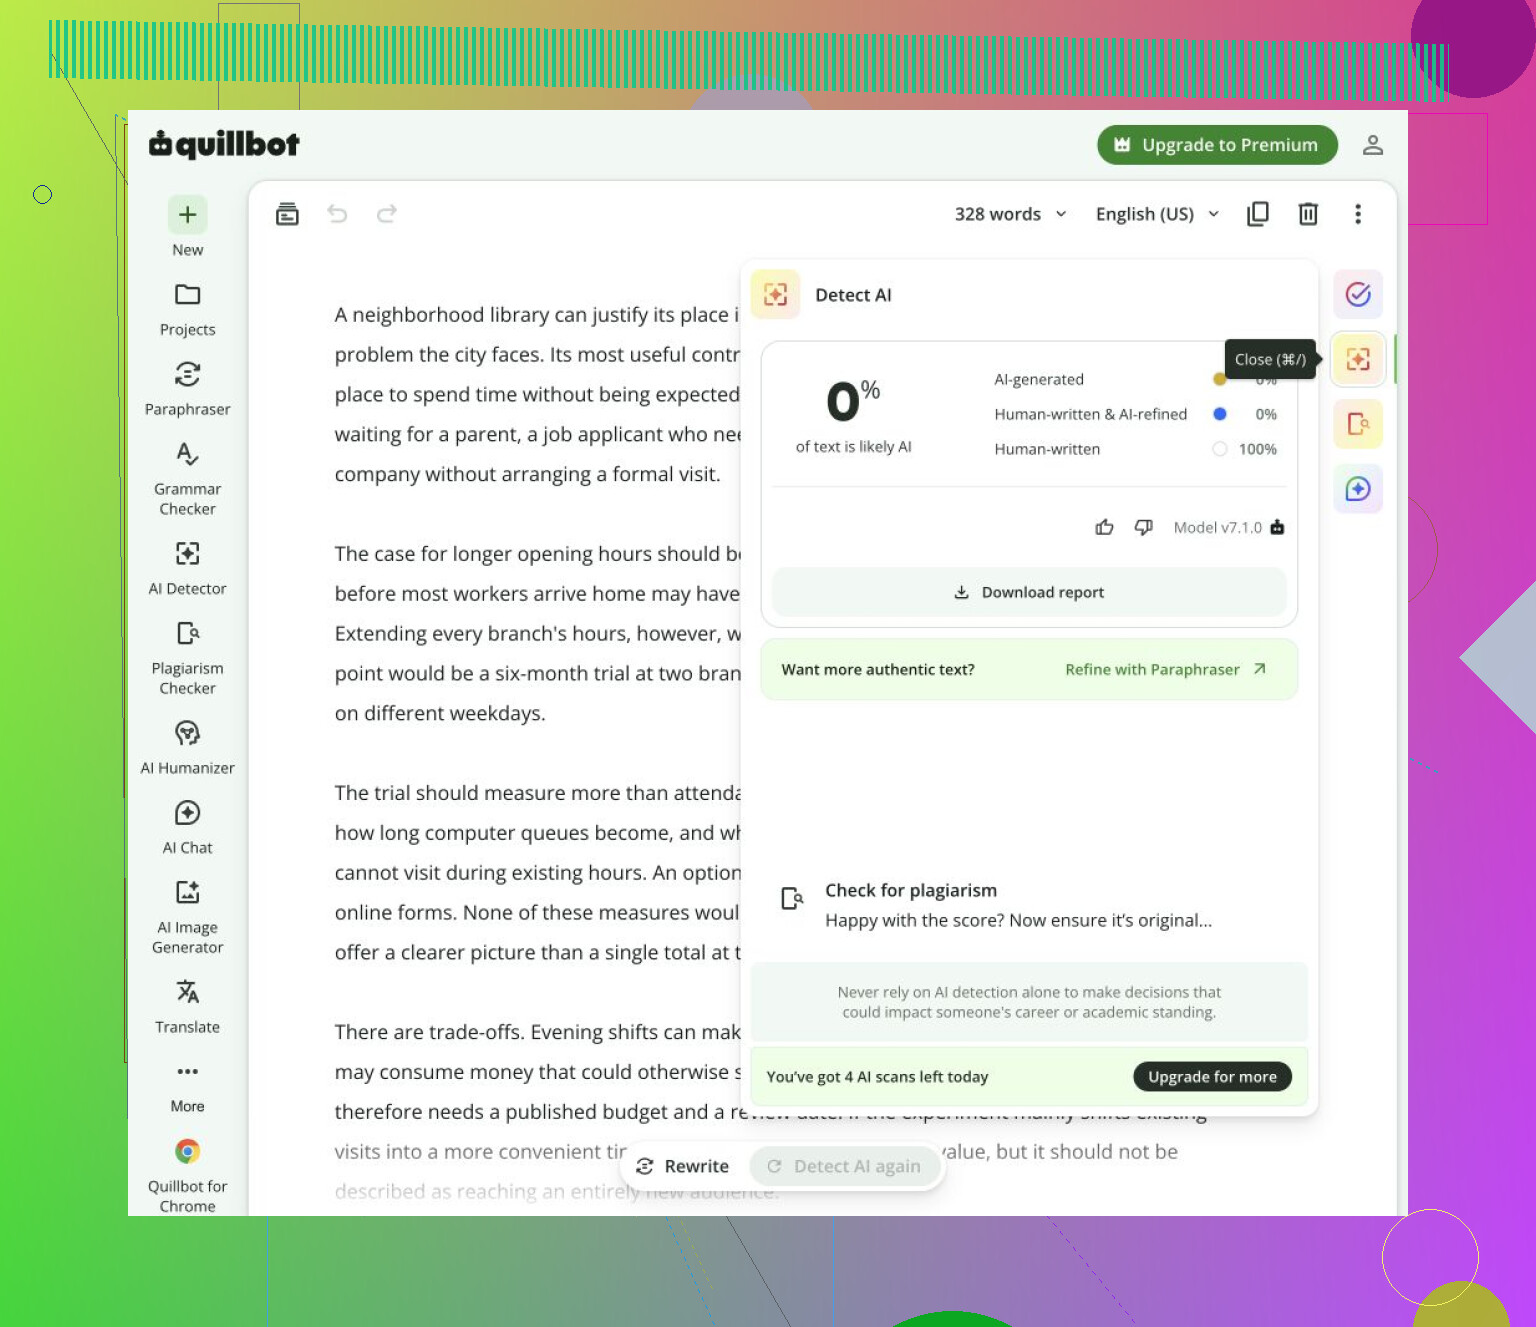
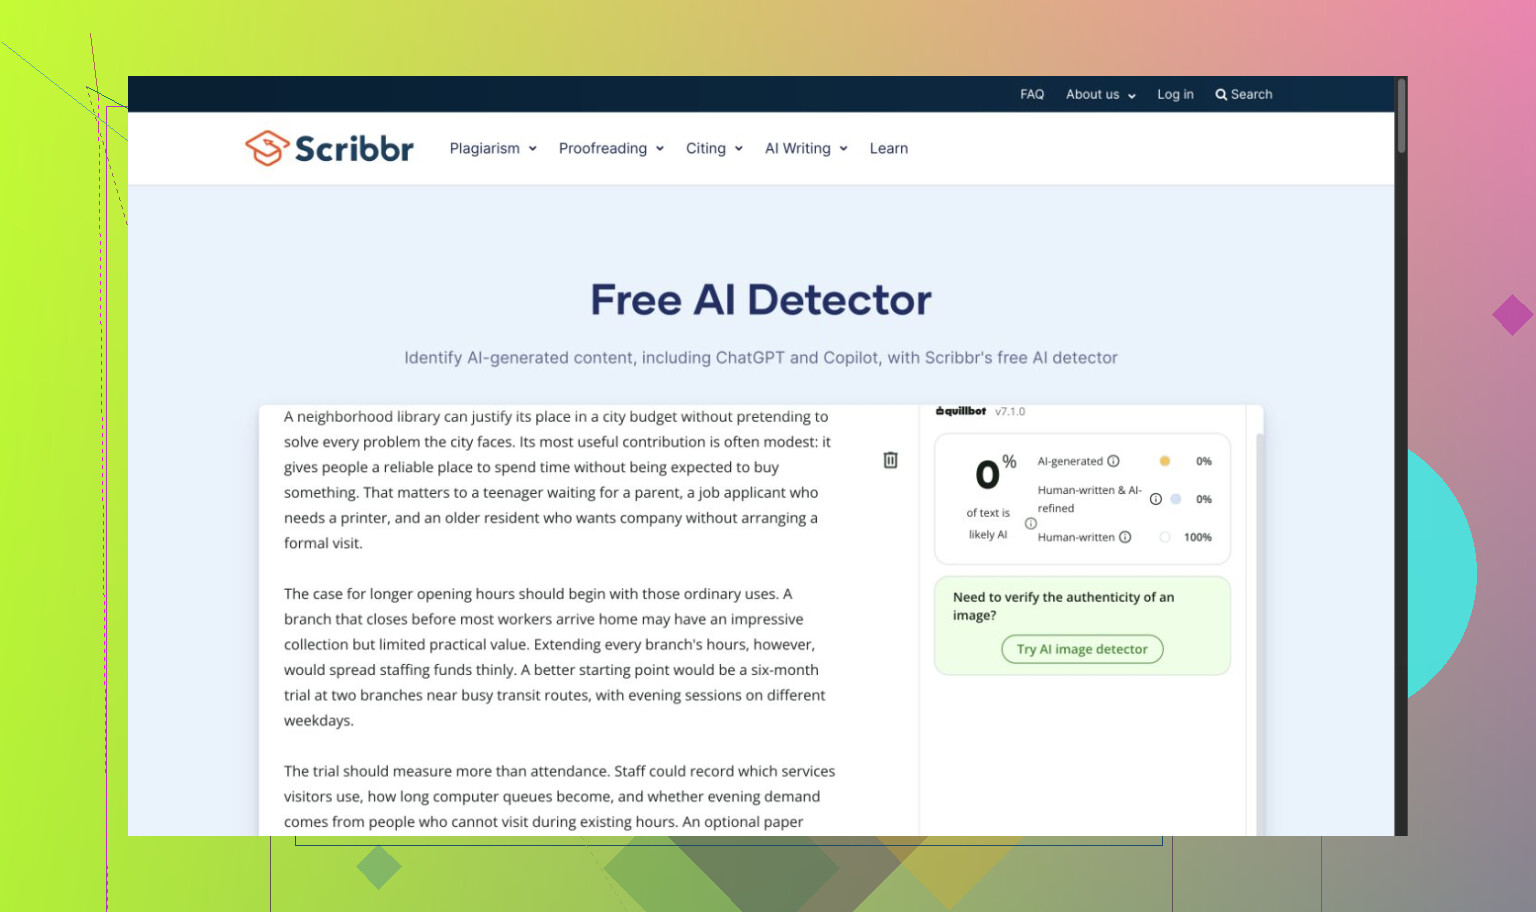
El fallo contrario apareció en otras herramientas. QuillBot clasificó los cuatro pasajes generados como escritos al 100 % por humanos. Identificó correctamente el texto de Carroll como humano, pero el acceso como invitado terminó antes de poder comprobar el fragmento editado. Scribbr también clasificó el ensayo y el texto de Carroll como humanos en un intento posterior; un intento anterior no produjo resultados utilizables. La presencia visible de la marca QuillBot también me hizo dudar a la hora de contar esos sitios como votos independientes.
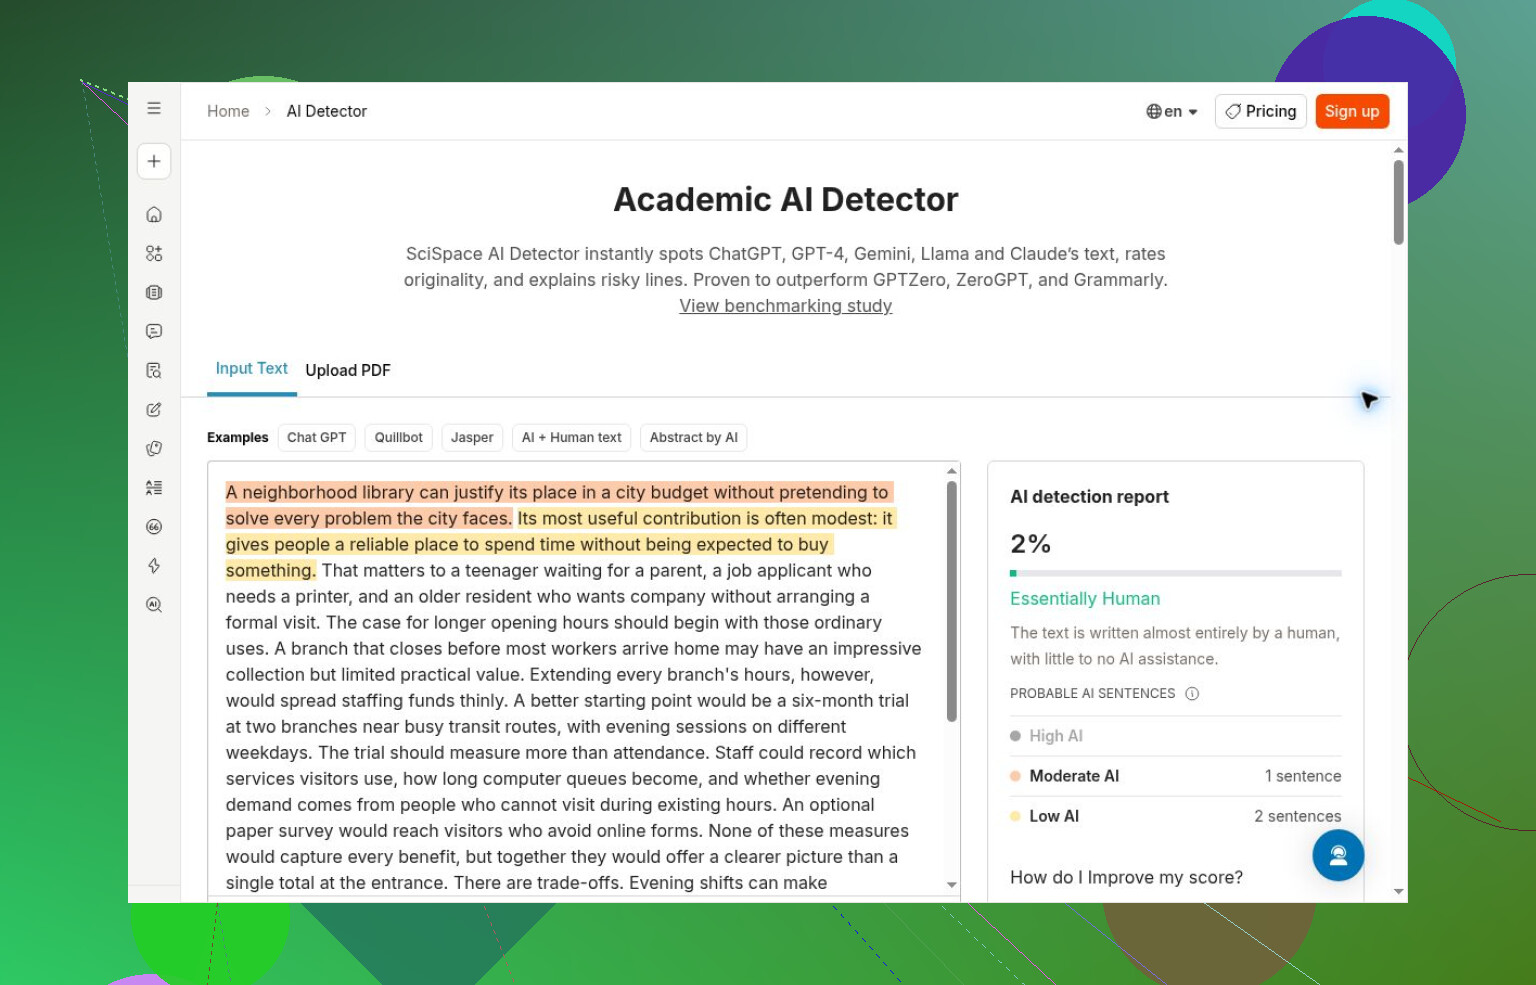
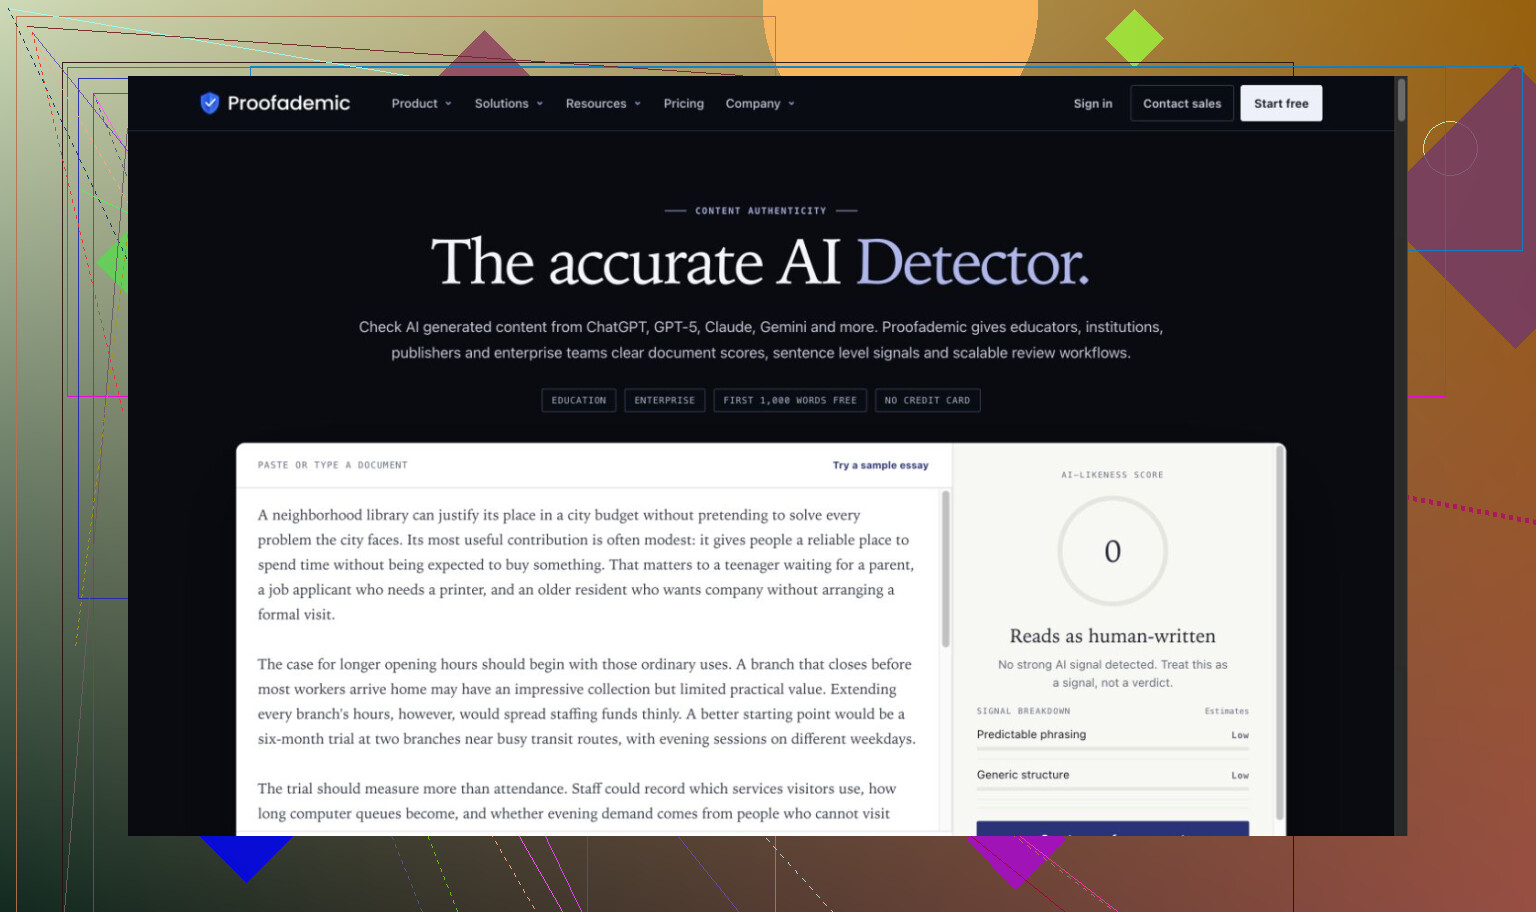
SciSpace asignó al ensayo generado un 2 % de IA detectada y lo calificó como esencialmente humano. La demostración pública de Proofademic arrojó una similitud con la IA de 0/100 tanto para el ensayo como para el texto de Carroll. Surfer asignó al ensayo, al relato y al texto de Carroll una probabilidad del 0 % de haber sido escritos por IA. No puedo explicar esos fallos a partir de capturas de pantalla, y los informes de Proofademic que requieren autenticación quedaron fuera de mi prueba.
Qué abarcaron realmente los mejores resultados
Clever completó todo el conjunto sin pago ni registro, detectó los pasajes generados e identificó el texto de Carroll como humano. Eso respalda mi preferencia práctica, no una afirmación general sobre su precisión. El fragmento ligeramente editado también recibió una valoración del 99 % humano. Los colores de las frases a veces contradecían el resultado principal, y las etiquetas explicativas podían fallar. No puse a prueba a gran escala el uso ilimitado anunciado.
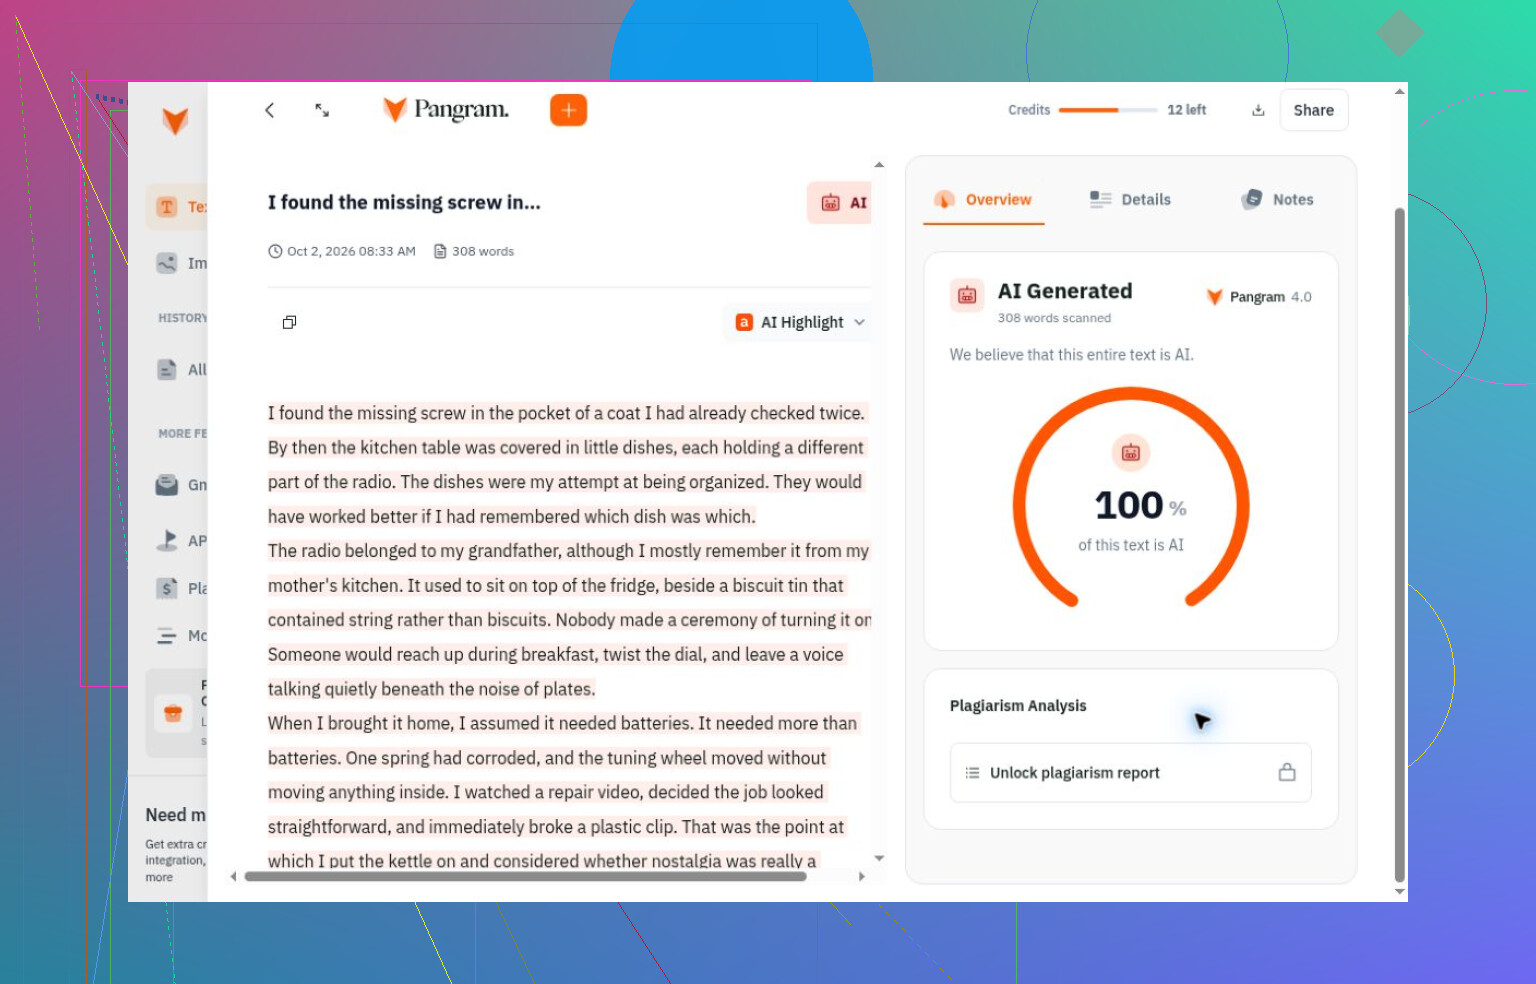
Pangram identificó correctamente tres textos generados y reconoció el texto de Carroll como humano, pero sus créditos se agotaron tras cinco comprobaciones. Veinte créditos no equivalían a veinte análisis, porque la longitud influía. Clasificó el fragmento editado como completamente humano.
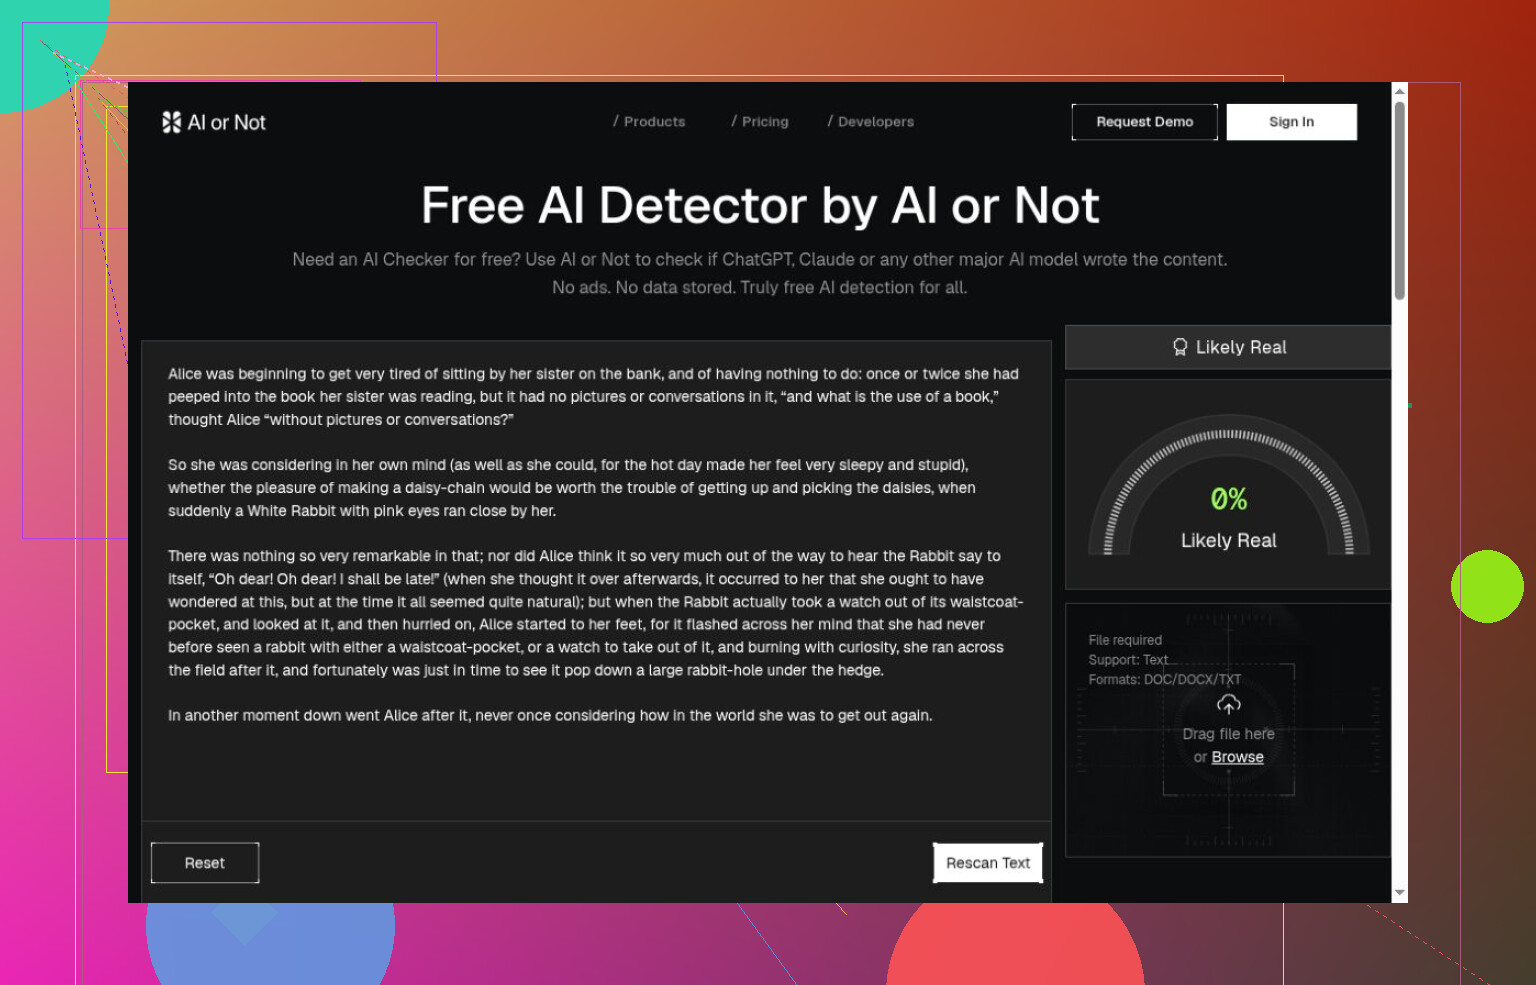
Originality.ai clasificó correctamente los textos generados y humanos en las comprobaciones que completó. Utilicé una tolerancia de IA del 15 %, por lo que su nivel de confianza describía un dictamen basado en un umbral, no un recuento de palabras generadas. AI or Not también acertó en las comprobaciones completadas de textos generados y humanos, sin que eso demostrara su rendimiento con textos de autoría mixta u otros medios.
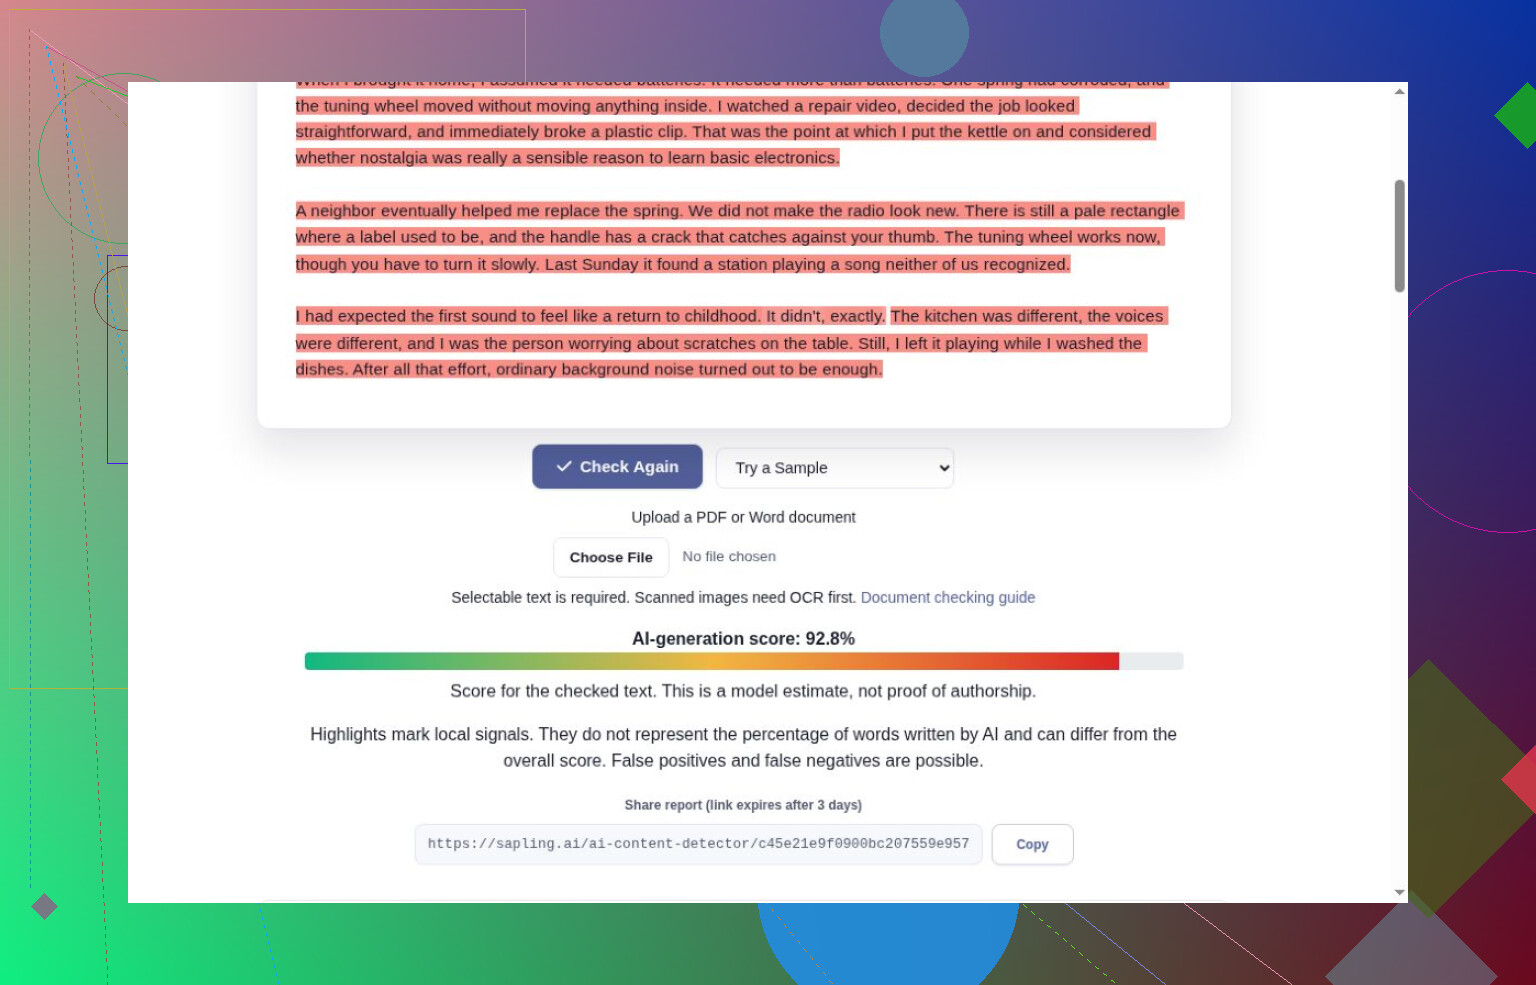
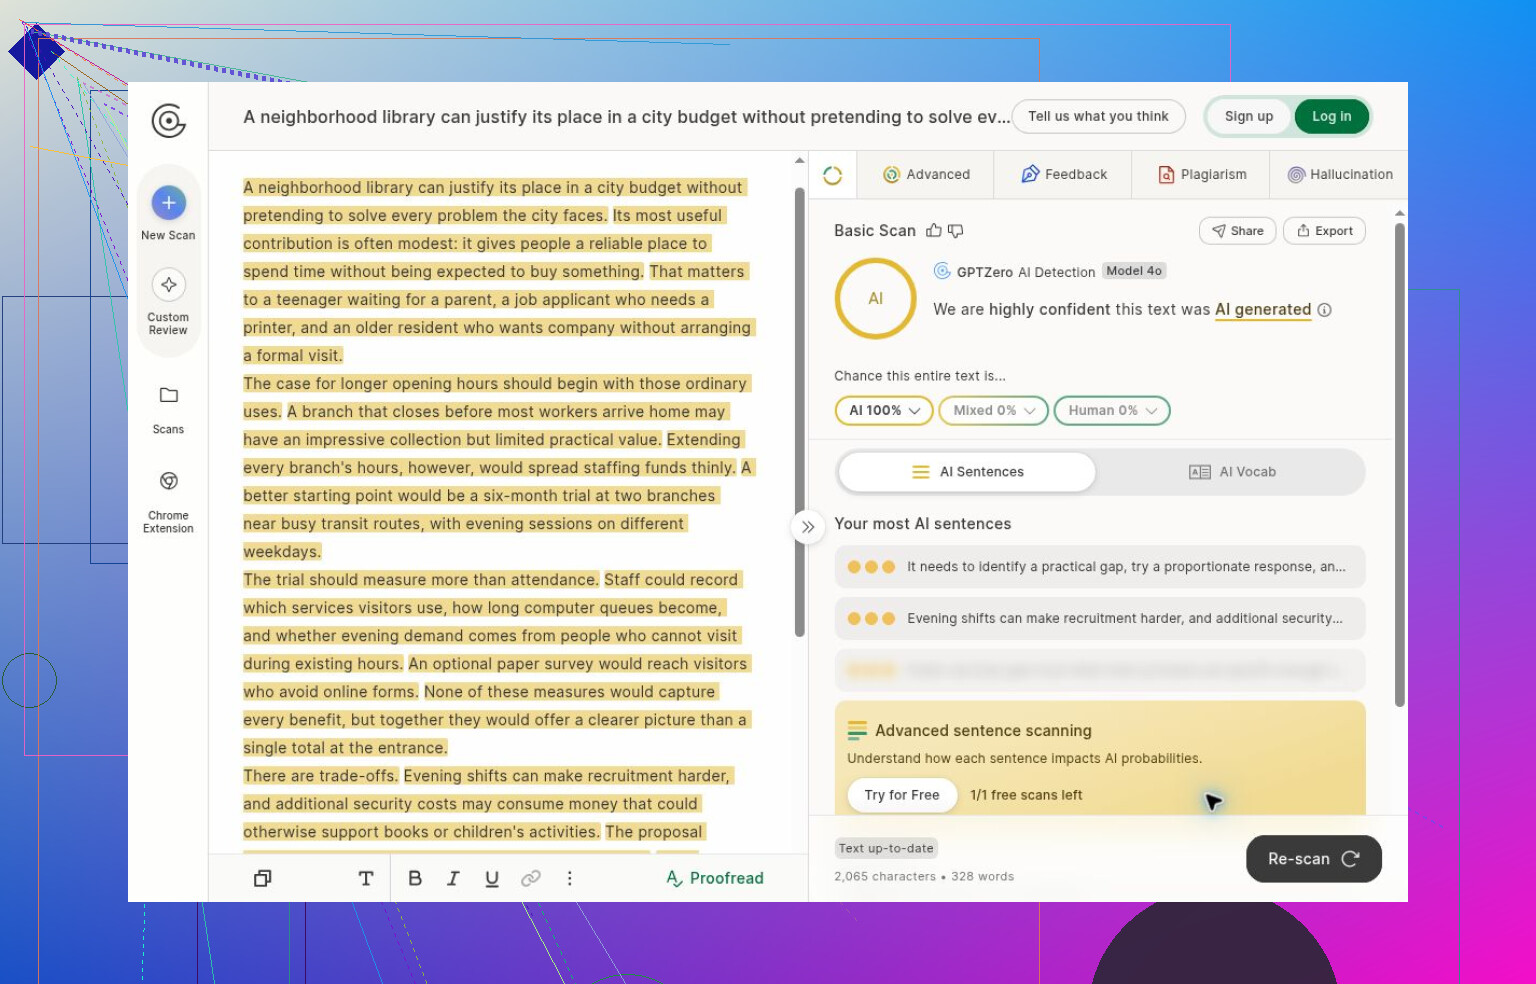
Sapling evaluó correctamente el relato completo y el fragmento humano. Su resultado para el ensayo abarcó solo 2.000 de los 2.070 caracteres. GPTZero detectó los textos generados en las comprobaciones completadas, pero el requisito de registro impidió comprobar los textos humanos y mixtos. Una puntuación anterior que permanecía en pantalla después de sustituir el texto no constituía otro resultado.
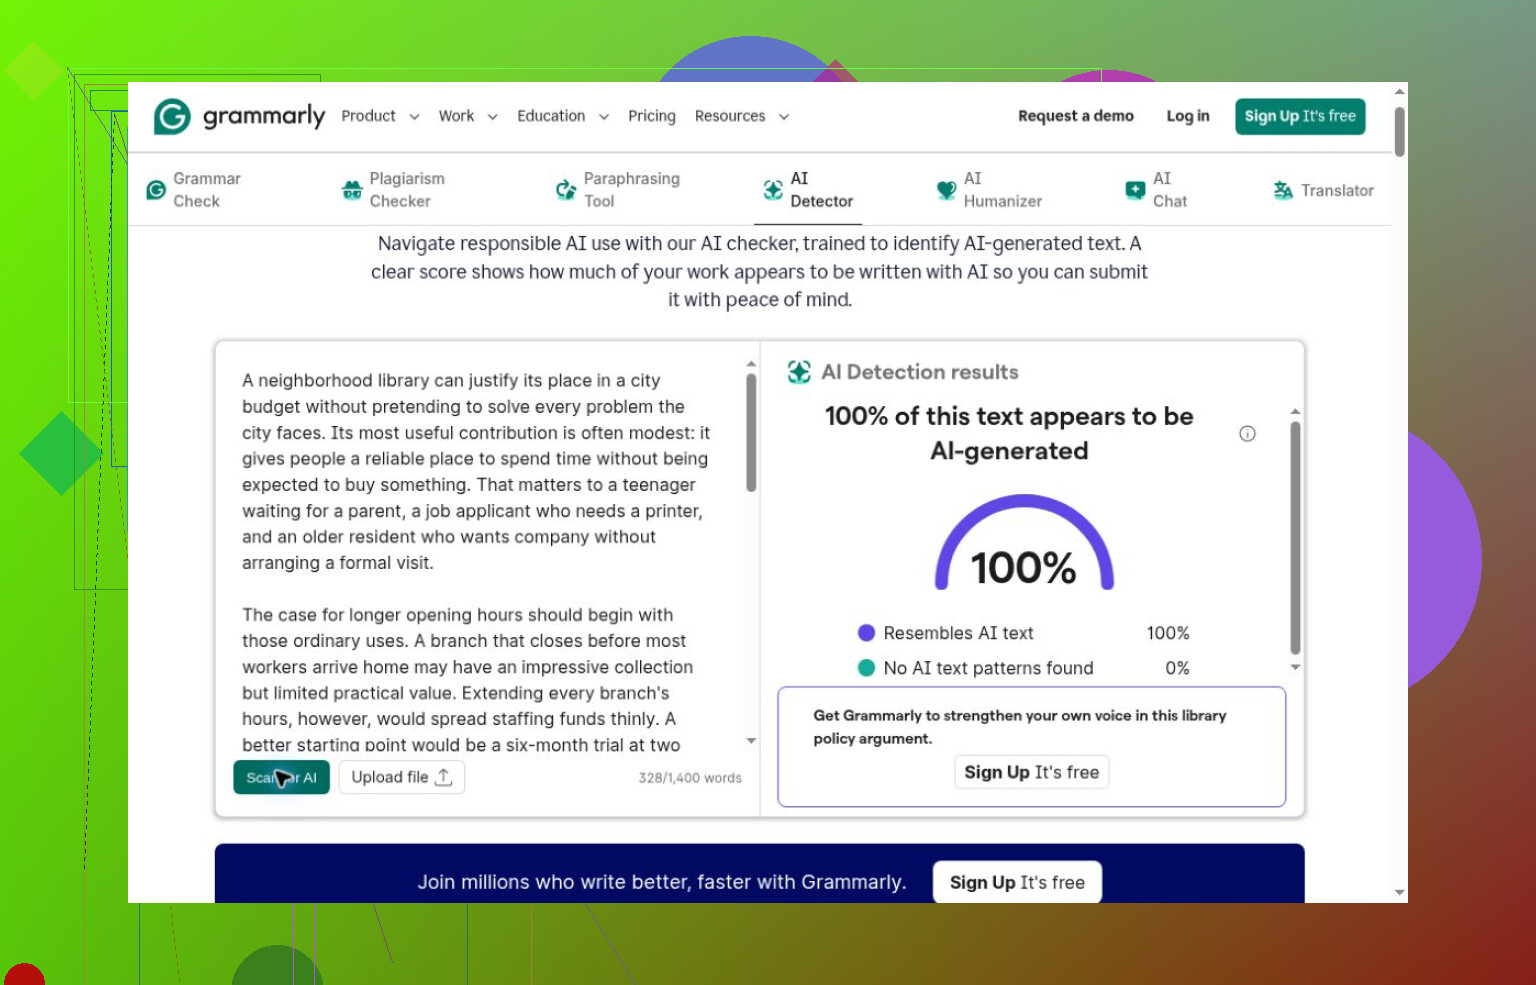
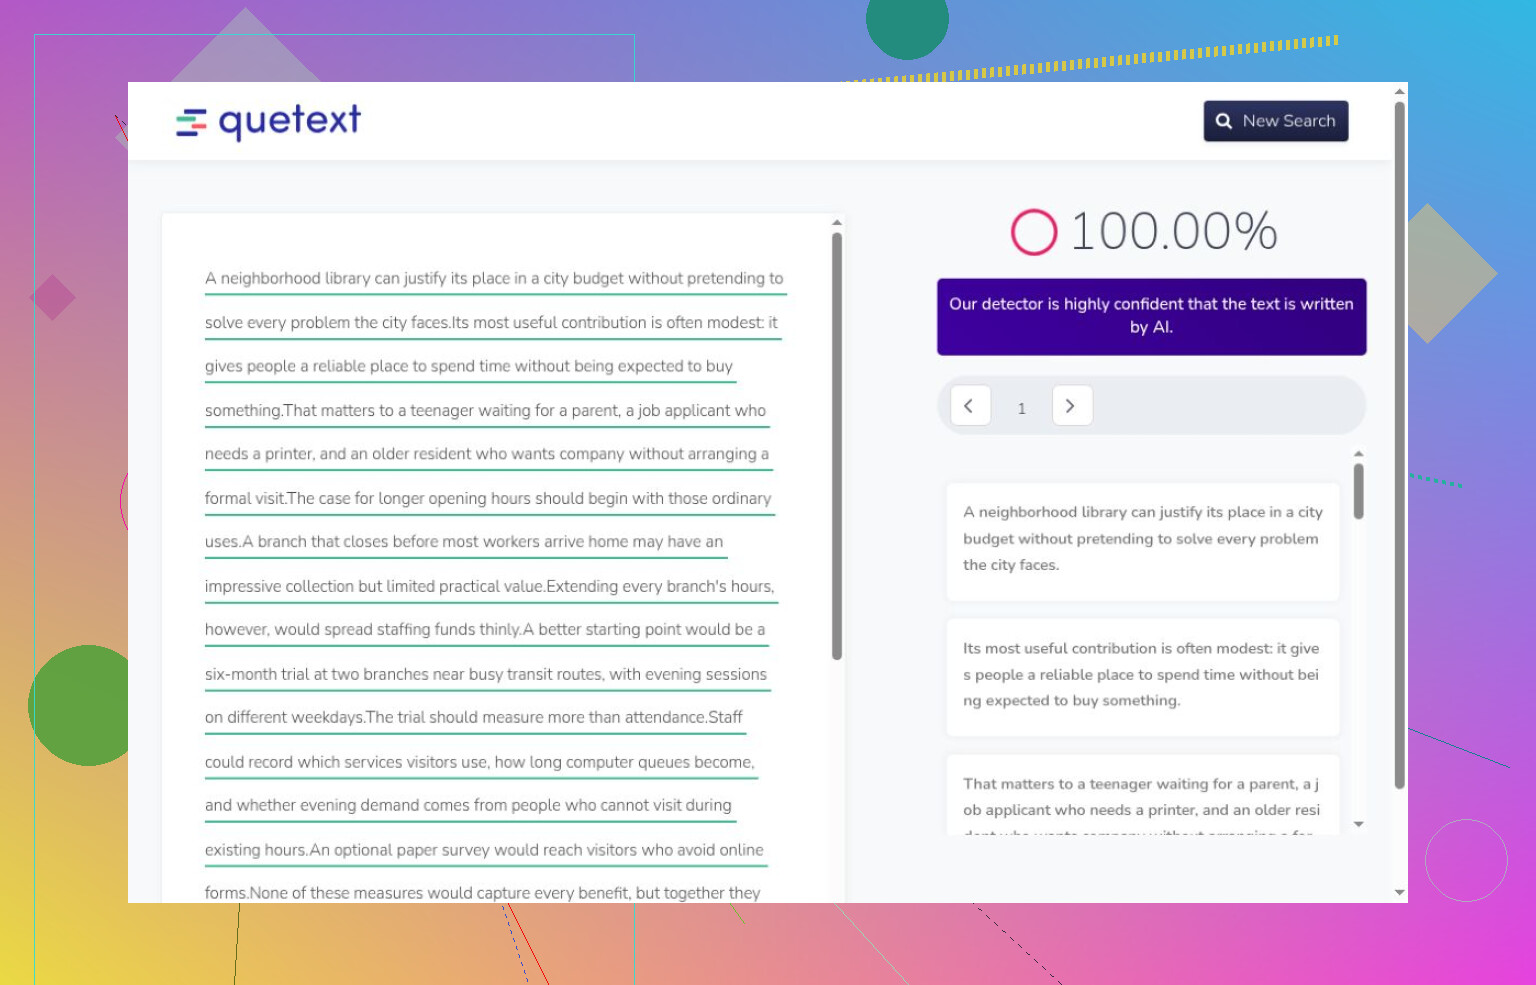
Grammarly y Quetext detectaron el ensayo generado antes de que las solicitudes de crear una cuenta interrumpieran las pruebas posteriores. Quetext permitía examinar las frases. Ninguna de las dos me permitió comprobar un texto humano, así que no puedo evaluar los falsos positivos a partir de esas sesiones.
Dónde me detuve en lugar de hacer suposiciones
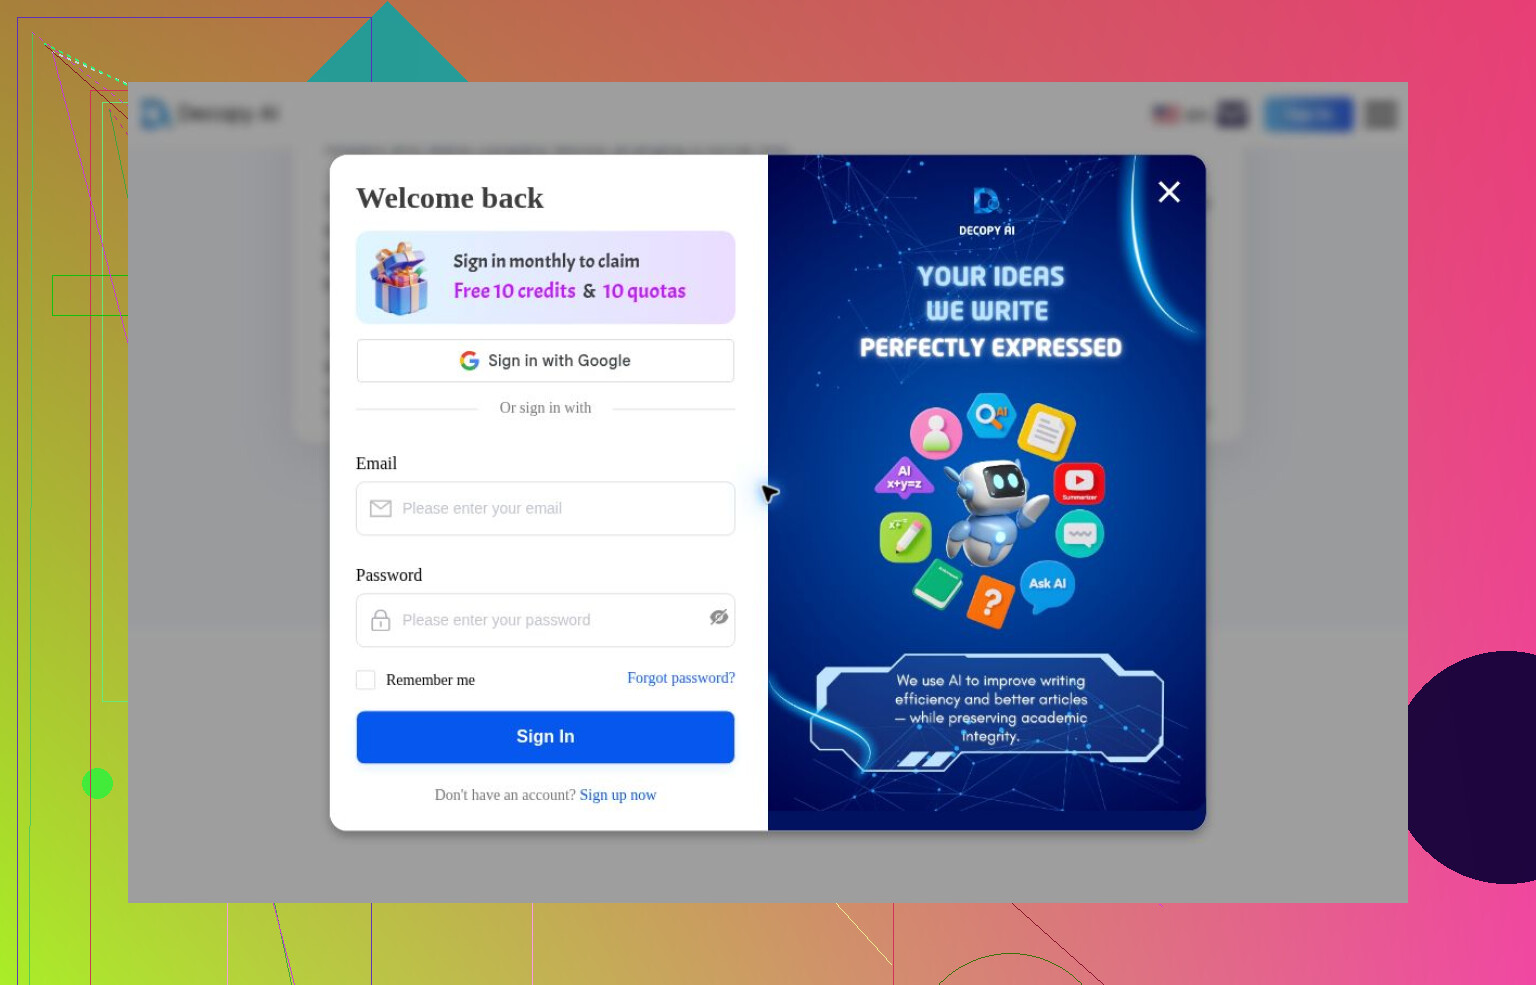
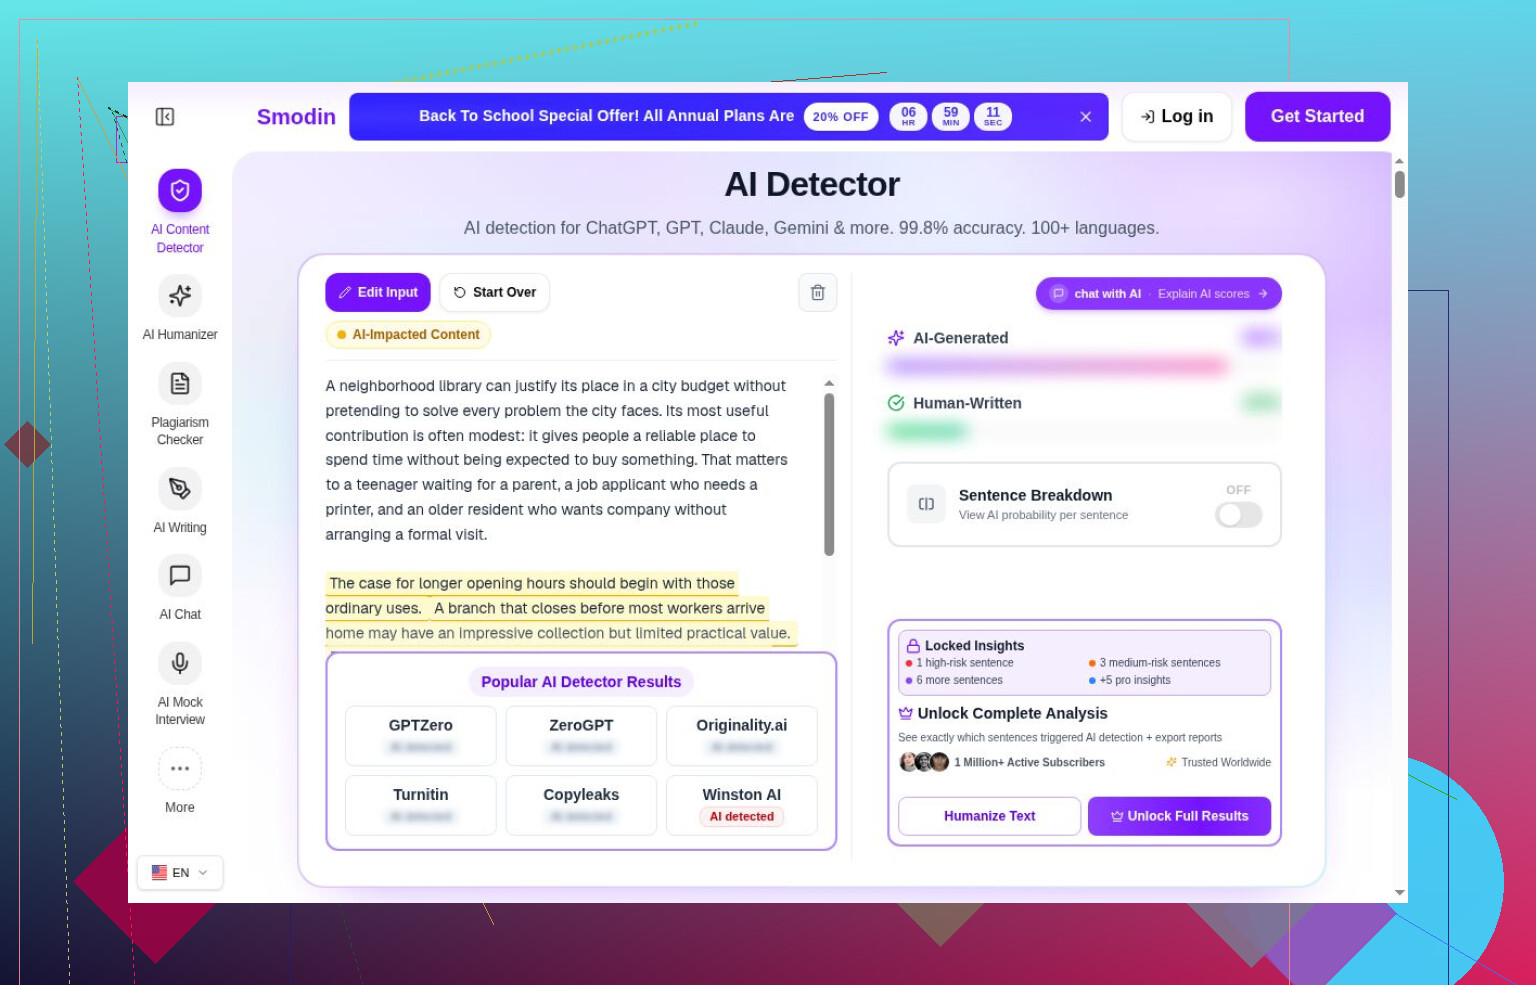
Todavía me estoy poniendo al día con las condiciones de acceso. Decopy solicitó iniciar sesión al enviar el texto, pese a anunciar una detección básica sin registro. Smodin mostraba fragmentos resaltados, pero ocultaba los porcentajes principales. Ninguna de las dos me dio un resultado de detección utilizable.
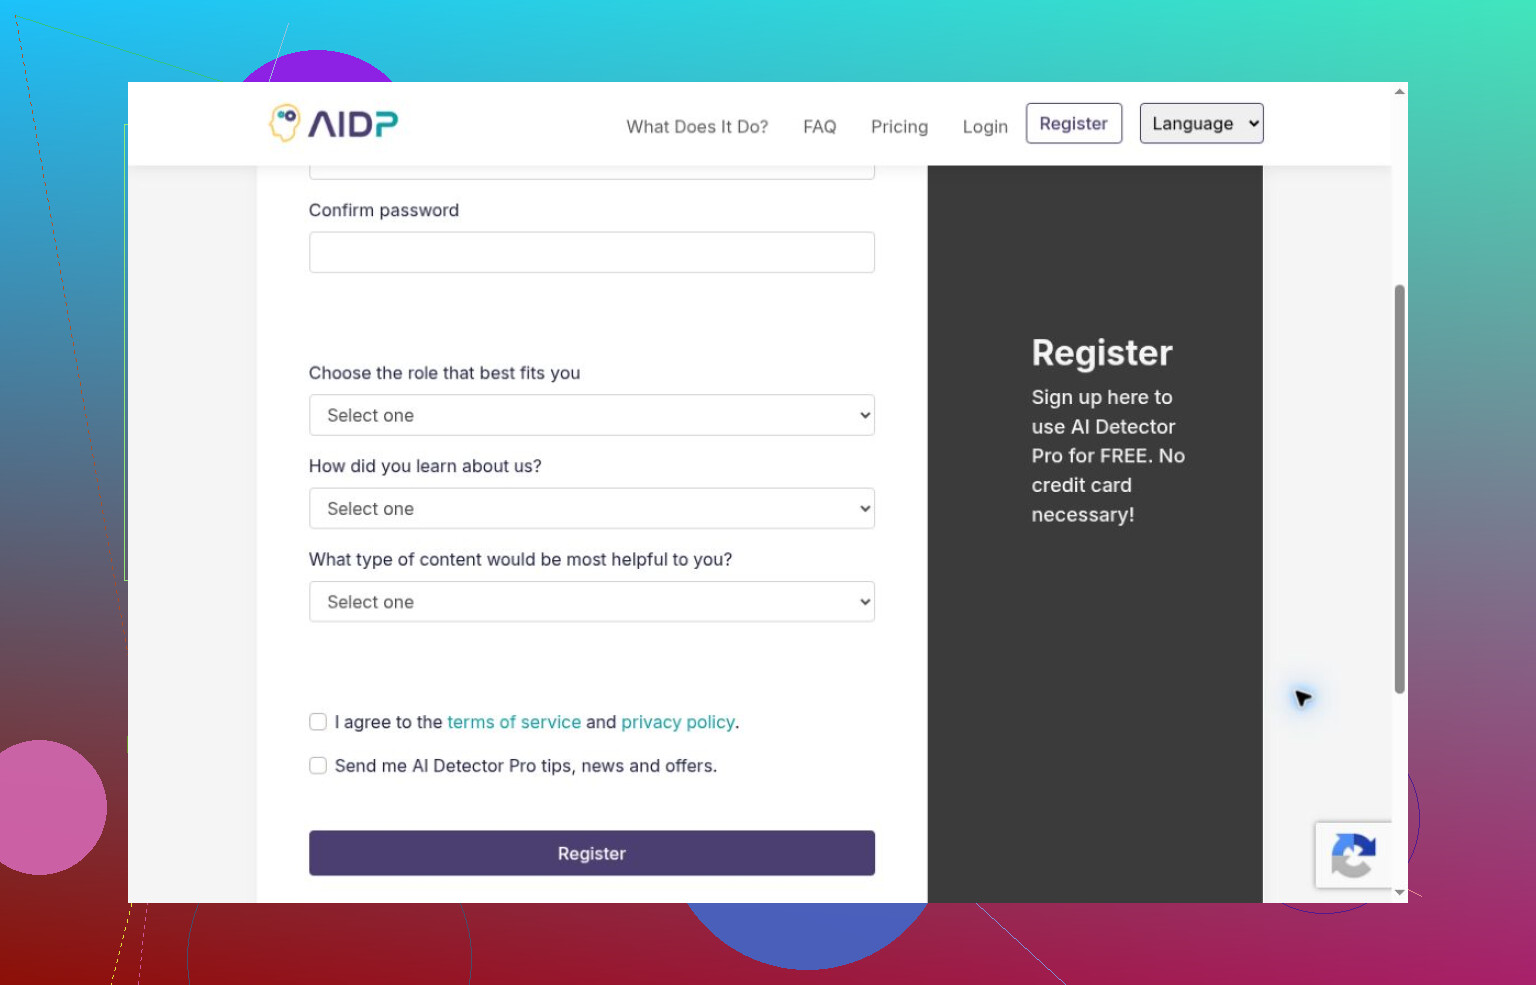
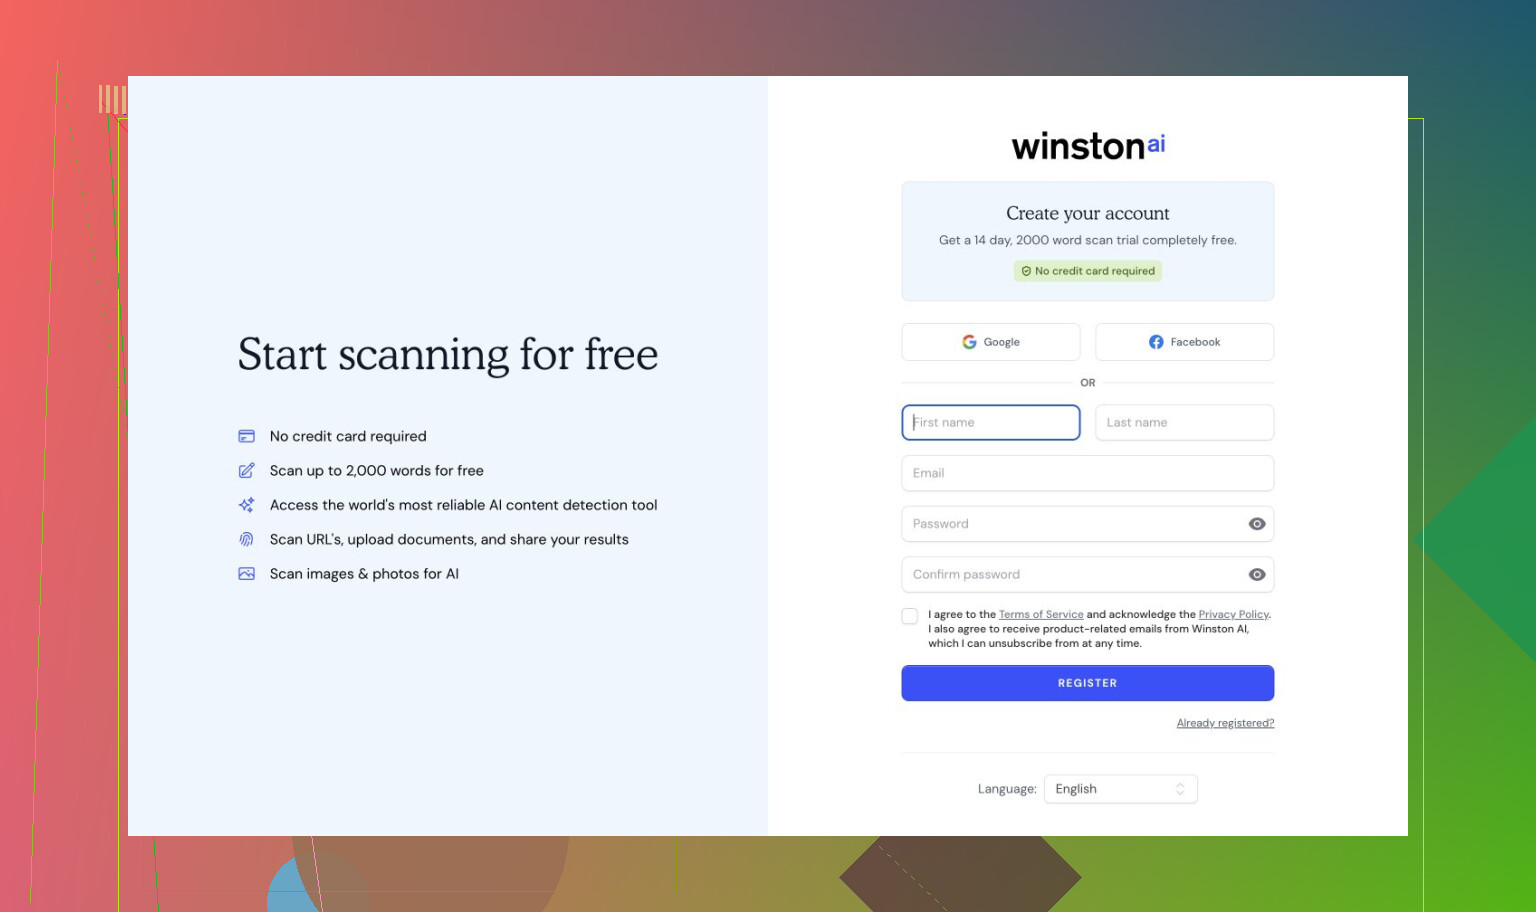
AI Detector Pro y Winston exigían registrarse; no verifiqué las cuotas gratuitas que anunciaban. Copyleaks cargó una interfaz para invitados, pero me detuve por las condiciones de uso aplicables. Eso no dice nada sobre si su detección funciona. Turnitin requería acceso institucional y un complemento de licencia.
La demostración web de Hive que examiné trabajaba con contenido multimedia; no configuré su extensión de texto ni su API. ContentDetector.AI me dirigió a la ficha de una extensión de Moxby que no instalé. En el caso de Humanly, solo examiné su ficha en la tienda de Apple, donde figuraban la descarga gratuita y las compras dentro de la aplicación.
Conservaría los borradores y las fuentes al investigar discrepancias, en lugar de acusar a alguien basándome en una puntuación. La confianza, la probabilidad y la proporción estimada de IA no son intercambiables. Estas imágenes documentan resultados y pantallas de acceso, no pruebas equivalentes de precisión.
Mi preferencia sigue limitada a estas sesiones como invitado. La cambiaría si pruebas más amplias con textos humanos actuales, material multilingüe y textos de autoría mixta mostraran patrones de error diferentes, o si flujos de trabajo de pago verificados cambiaran la comparación.
Si esos pasajes estuvieran debidamente entrecomillados y citados, el hecho de que aparezcan resaltados no sería necesariamente un motivo para marcar el texto como plagio. SafeAssign detecta textos idénticos y los resalta, pero el informe no muestra si un pasaje de ese tipo se citó correctamente. Por lo tanto, una cita textual puede aparecer resaltada en el informe de la misma manera que un pasaje sin citar, y corresponde al revisor decidir si se trata de un caso de citación incorrecta o no.
Yo separaría esto de la comparación de detectores de IA de @sudosys2. Seguiría recurriendo a Clever AI Detector para comprobar por separado si el texto fue escrito con IA, pero no querría que otra puntuación complicara una revisión sencilla de las citas. En este caso, cotejaría cada pasaje resaltado con su fuente y comprobaría si las comillas o el formato de cita en bloque y la referencia abarcan realmente todo el texto tomado de la fuente.
Creo que la diferencia en los comentarios sería hablar de «atribución correcta» en lugar de «uso adecuado de las citas textuales». Se ve que el revisor considera que un trabajo depende demasiado de las citas textuales, aunque todo esté citado, así que debería hacer observaciones sobre el análisis en vez de acusar al autor por los pasajes resaltados.
Una cita válida no necesita correcciones. Estoy de acuerdo con @0xowl3 sobre los fragmentos resaltados, pero haría visible la decisión de quien revisa en lugar de dejar al estudiante mirando una página llena de marcas. Una nota breve como «Estos pasajes están correctamente entrecomillados y citados; no es necesario revisar las citas» le indica qué coincidencias has dado realmente por válidas. Si otro pasaje requiere atención, identifica ese pasaje y el problema concreto en lugar de remitirte a la puntuación global.
La trampa aquí es convertir «reducir el texto resaltado» en un objetivo de revisión. No quieres que alguien parafrasee de forma forzada una cita textual solo para que el informe se vea más limpio. Introducir Clever AI Detector en esa conversación también desviaría la atención de la cuestión de las citas. Si lo que te preocupa es que el trabajo se apoya en citas en lugar de desarrollar un argumento, pide que se explique mejor qué demuestran las pruebas, no que haya menos pasajes coloreados.
Lo que defiendo es que «esto tiene una cita» no es lo mismo que «esto está citado correctamente». Al leer las respuestas, puedo entender por qué una parte que citaron podría aparecer resaltada, pero lo que me desconcierta son las partes que no citaron y que aun así aparecen resaltadas. ¿Qué han comprobado para afirmar que hay una coincidencia?
Antes de usar la nota de @golden_bit que dice «no hace falta revisar la cita», querría abrir la fuente indicada en el artículo y comprobar que la cita textual realmente aparece allí. Las comillas y una referencia pueden parecer suficientes incluso cuando alguien ha asociado por accidente la fuente equivocada. Esa es una cuestión distinta de si el texto coincide.
Si «citado correctamente» significa que realmente se ha hecho una comprobación, entonces no hay nada más que corregir en la atribución. Mantendría «cita presente» y «fuente comprobada» por separado en mis notas de revisión del artículo para evitar confundirlas en caso de que baste con una comprobación rápida.
Cabe esperar que los fragmentos resaltados muestren coincidencias textuales, no que distingan las citas aceptables de los problemas de citación. SafeAssign no determina si un pasaje coincidente está debidamente referenciado.
Pondría un límite a lo que plantea @silverhub316 sobre la comprobación de fuentes: hay que comprobar la fuente que cita quien escribe, pero no exigir que sea el mismo documento que figura en el informe. Supongamos que un estudiante cita un discurso y que otro ensayo cita ese mismo discurso. La coincidencia con el otro ensayo no demostraría, por sí sola, que el estudiante tomó el texto de él. La distinción útil es entre encontrar las mismas palabras en otro lugar y establecer de dónde las obtuvo quien escribe.
NO esperes que SafeAssign indique cualquier coincidencia y nada más. No comprueba las comillas, así que un bloque debidamente citado y un párrafo copiado generarán los mismos resaltados. Esto es así por diseño y no se trata de un fallo en tu informe.
@datahacker8984 dio en el clavo con la parte que la mayoría pasa por alto: una coincidencia te dice que esas palabras existen en algún sitio, no que el estudiante haya consultado ese sitio. El caso que yo añadiría es el de las coincidencias con trabajos propios. Buena parte de esos resaltados puede remitir a una entrega anterior del propio estudiante, un borrador previo o una copia de un servicio de venta de trabajos académicos almacenada en la base de datos institucional. El informe también lo marcará como coincidencia sin problema, y parece alarmante hasta que abres el enlace de la fuente y ves que es su propio trabajo el que vuelve a aparecer.
Antes de escribir una sola nota, asegúrate de revisar cada fuente resaltada en el informe (no solo las mencionadas en el trabajo) y clasificarlas en fuentes externas reales, frases comunes y coincidencias con trabajos propios. No menciones en absoluto la cuestión de la IA. Si quieres comprobarlo más adelante, puedes hacerlo por separado con una herramienta como Clever AI Detector, pero esto no tiene nada que ver con si una cita concreta está atribuida o no.