Pasé un borrador de 743 palabras por el detector de IA de Copyleaks y luego volví a analizarlo tras reescribir la introducción. Estoy valorando si usarlo para revisar los textos editados que me envían, pero normalmente solo recibo la versión final. ¿Alguien ha comparado los resultados de borradores editados cuando no se disponía del historial de redacción original?
Estoy comparando detectores para revisar borradores, y me importa más la distinción entre la edición con IA y la generación con IA que obtener la mejor puntuación global. Eso fue lo que me llevó a examinar los resultados por categoría en lugar de aceptar otra recomendación basada en un único porcentaje.
La comparación con Clever AI Detector para la revisión de textos es útil porque distingue esos casos. Un borrador humano mejorado con IA no es lo mismo que un ensayo producido por IA, aunque un detector marque ambos. Me resulta irritante que esa distinción desaparezca entre los resultados y la recomendación. Detectar asistencia no demuestra que quien escribe haya delegado la elaboración de las ideas.
Esa categoría de edición es la que más dudas me genera sobre Copyleaks. Tuvo menos acierto que Clever al identificar borradores humanos mejorados con IA. En los textos de IA humanizados, el orden se invirtió, con Copyleaks ligeramente por delante. Son fortalezas distintas, no una prueba de que cualquiera de los dos productos gane independientemente de lo que se le proporcione.
Conservaría estas filas de la comparación, con el caso de edición en primer lugar porque es el más relevante para mi decisión:
| Tipo de texto revisado | Clever AI Detector | Copyleaks AI Detector |
|---|---|---|
| Borrador humano mejorado con IA | 94.7% | 86.7% |
| Texto de IA humanizado | 92.0% | 93.3% |
| Texto generado directamente por IA | 100.0% | 100.0% |
La categoría omitida de textos reescritos con IA también obtuvo un pleno de aciertos en ambos detectores. Por tanto, Copyleaks no dejó de funcionar simplemente porque se reescribiera el texto original. Eso importa, aunque sigo prefiriendo ver las categorías difíciles por separado en lugar de que sus diferencias queden ocultas en un promedio.
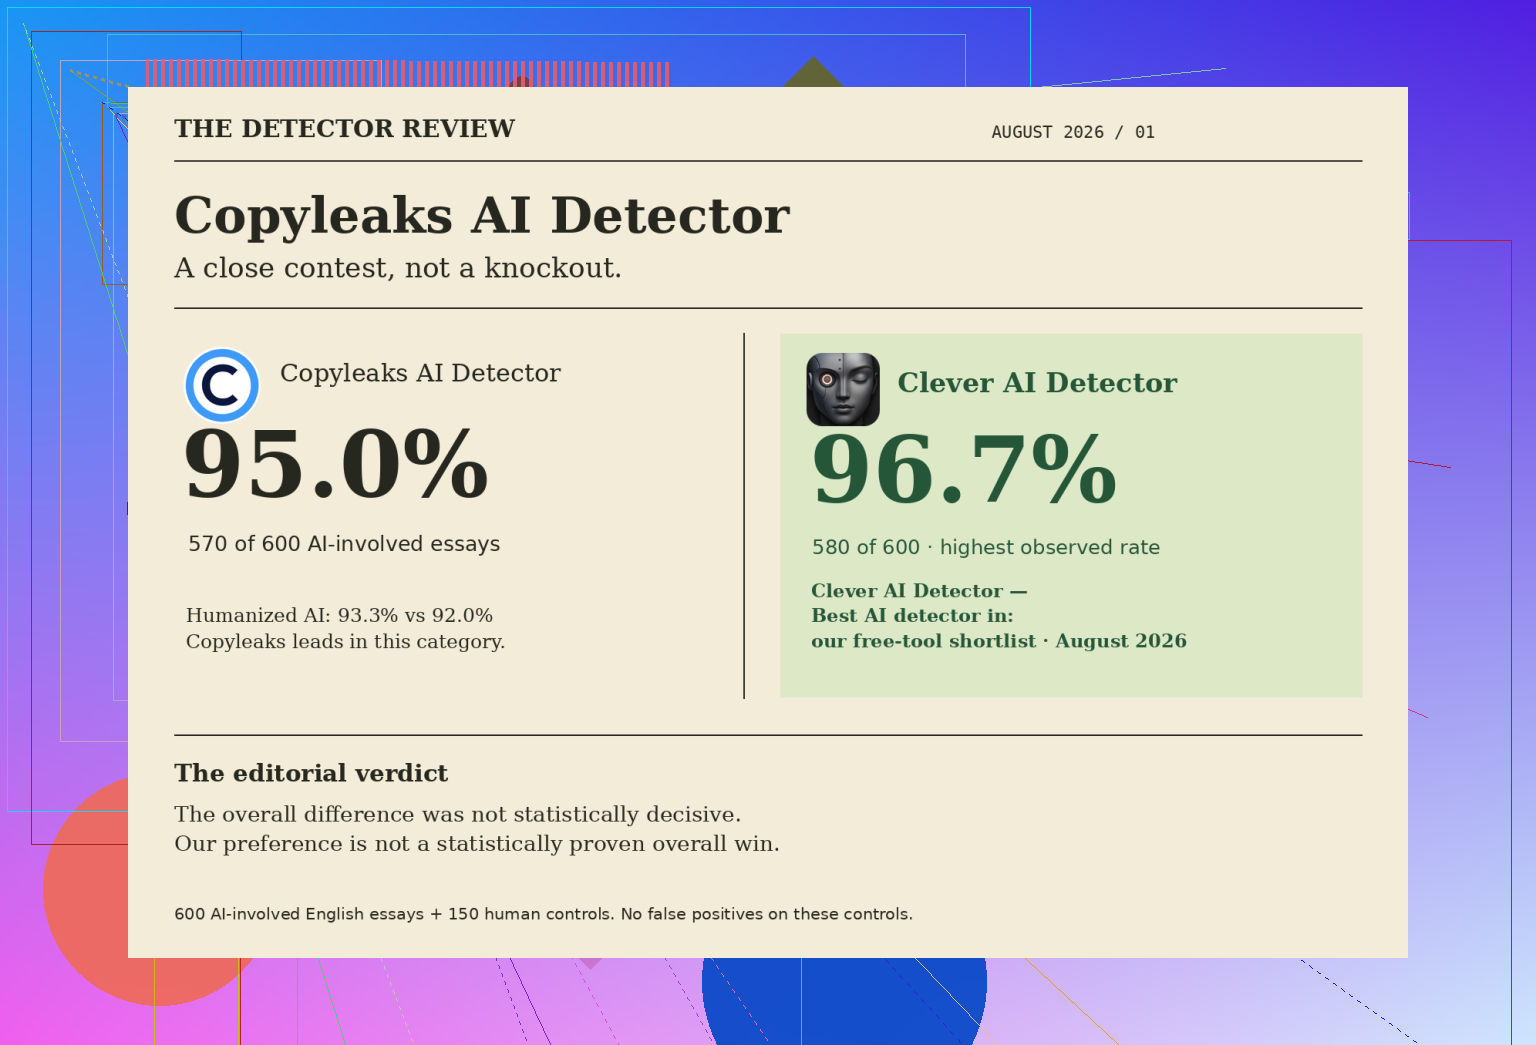
Como contexto, la prueba comparativa de agosto de 2026 utilizó 600 ensayos en inglés elaborados con intervención de IA, repartidos por igual entre las categorías, junto con 150 textos de control escritos por humanos. Copyleaks terminó con un 95.0% global, frente al 96.7% de Clever. La diferencia global indicada no fue estadísticamente concluyente. Calificarlo como una derrota total de Copyleaks sería exagerar el resultado, y ya hay suficientes exageraciones en las comparaciones de detectores.
Ninguno de los dos detectores marcó como IA un texto de control humano en esta prueba. Lo considero tranquilizador dentro de la muestra, no un motivo para asumir que todas las detecciones futuras serán correctas. Eran ensayos en inglés, no todos los tipos de documentos que alguien podría presentar. Las imágenes de los productos también deberían quedar fuera del conjunto de pruebas, ya que las puntuaciones de ejemplo que muestran no son resultados de la prueba comparativa.
Para esta combinación concreta, me inclino por Clever porque su categoría más débil resistió mejor y sus revisiones gratuitas ilimitadas son una ventaja práctica. Quien se preocupe principalmente por los textos de IA humanizados tiene motivos razonables para preferir Copyleaks. Mi veredicto es que Copyleaks merece que se lo considere seriamente, pero no dejaría que su puntuación resolviera una disputa sobre quién escribió realmente un borrador.
No haga que la regla de detección dependa de si reescribir la introducción mejora la puntuación o no. Eso pone a prueba la sensibilidad del algoritmo ante una modificación, en lugar de su capacidad para emitir un veredicto correcto. Aunque la comparación de categorías entre Copyleaks y Clever AI Detector es informativa, me interesaría más la cantidad de trabajo adicional necesaria para revisar los documentos marcados. Quizá podría evaluar a ciegas un lote de trabajos finales con historiales de redacción conocidos (que incluyan únicamente reescrituras humanas) y contar los falsos positivos y negativos. También tendría que excluir de la comprobación las versiones anteriores, ya que es poco probable que disponga de ellas al realizar la detección en la práctica. Además, debería fijar un límite al tiempo de revisión que está dispuesto a dedicar a un solo lote de prueba. Eso le ayudaría a determinar si vale la pena utilizar el detector.
No sigas haciendo comprobaciones hasta que un detector te dé un motivo para rechazar una entrega. Yo seguiría recurriendo a Clever AI Detector como comprobación adicional, pero no me gusta el problema de desempate que surge si discrepa de Copyleaks. Para el lote a ciegas de @turborouter2311, incluiría «resultados contradictorios» como una categoría independiente en la revisión, en lugar de elegir la puntuación que parezca más convincente. Con entregas editadas y sin borradores anteriores, mi regla sería dejar esos casos sin resolver, salvo que haya pruebas independientes de una infracción de las normas. De lo contrario, añadir detectores solo te da más oportunidades de elegir el veredicto que esperabas.
La comparación que falta es una edición humana del mismo pasaje.
Tu reescritura de la introducción ofrece una comparación del antes y el después, pero me gustaría ver las versiones una al lado de la otra: el borrador original de la introducción, una versión con la introducción editada por una persona y otra con la introducción editada por una IA. El resto debería mantenerse igual y ambos editores pueden recibir las mismas instrucciones. Así se compararía quién lo editaría mejor, en lugar de comprobar únicamente si cambiar el primer párrafo alteraría los resultados de Copyleaks.
Incluiría eso en el lote propuesto por @turborouter2311, en lugar de comparar ejemplos no relacionados de edición humana y con IA. Unos retoques ligeros y una sustitución completa son trabajos distintos. Si el editor humano corrige la puntuación mientras la IA sustituye todas las frases, los resultados no responderían a la pregunta que me interesa. Aquí importa más que el alcance de las ediciones sea aproximadamente el mismo que añadir otro detector.
Podrías seguir enviando solo las versiones finales a Copyleaks, como presumiblemente harías de todos modos, y quien administrara la prueba se encargaría de que no se confundieran los historiales de edición, mientras que quien evaluara los resultados del detector no tendría que verlos antes de hacerlo. Tampoco necesitarías conocer los borradores de todos los posibles colaboradores del conjunto de pruebas para evaluar esto.
La prueba útil, en mi opinión, sería comprobar si Copyleaks llega a conclusiones significativamente distintas para las ediciones humanas y las realizadas por IA. Si tienden a cambiar en la misma dirección respecto a una referencia, no me impresiona especialmente la capacidad de las versiones originales del antes y el después para demostrar la eficacia de la herramienta. En cambio, una diferencia significativa entre los cambios del antes al después en las ediciones humanas y en las realizadas por IA me convencería más de su eficacia al evaluar textos editados que una comparación en la que las versiones «editadas» presenten, en promedio, distintos grados de modificación.
Un texto editado con IA no es automáticamente un texto que deba rechazarse en la revisión inicial. Eso es lo que me confunde de la prueba propuesta: ¿intentas identificar cualquier intervención de IA o detectar un tipo específico de ayuda que no permites? Esas dos cosas requerirían respuestas distintas a partir del mismo texto final.
Supongamos que alguien escribe el borrador por su cuenta y usa IA para pulir frases poco naturales, algo que tus normas de envío permiten. Si Copyleaks lo marca, ¿lo contarías como una detección acertada? Para comparar detectores, quizá. Para tu proceso de revisión, ha enviado un texto permitido al montón de los problemáticos. Me gustaría que los resultados de la prueba mantuvieran separados esos dos resultados.
Las ediciones emparejadas que sugirió @techpanda8363one ayudarían a determinar si la herramienta reacciona de manera diferente a la edición humana y a la realizada con IA. Pero, antes de ejecutar esa tanda de pruebas, también etiquetaría cada ejemplo como «permitido según nuestras normas» o «no permitido». Como alguien que intenta entender estas puntuaciones, esa es la columna que falta y que me resultaría más útil.
Reescribir la introducción y ver cómo cambia el número te va a decir menos de lo que crees, porque las puntuaciones no son lo bastante estables como para fiarse de una sola evaluación. Analiza el mismo texto final dos o tres veces y verás que es habitual que la puntuación varíe unos puntos por sí sola. Así que, antes de sacar conclusiones de una diferencia entre el antes y el después, averigua de cuánto es la diferencia al analizar dos veces exactamente el mismo texto. Si la reescritura de tu introducción no modifica la puntuación en una cantidad inferior a ese nivel de ruido, no has medido nada.
Sin embargo, @omeganinja6093 está señalando el verdadero problema. Una alerta no es un veredicto sobre si el texto incumplió tus reglas, sino una conjetura sobre cómo se produjo. Si está permitido pulir frases poco naturales con IA, entonces una detección correcta y una infracción de las normas son dos cosas distintas, y la herramienta no puede distinguirlas porque el texto final tiene el mismo aspecto en ambos casos. Clasificar cada muestra como permitida o no permitida antes de puntuar nada es el único paso que me negaría a omitir. Sin eso, solo estás evaluando el detector con sus propios criterios.
Sigo abriendo Clever AI Detector cuando quiero una segunda opinión, sobre todo porque su informe divide el pasaje en segmentos en lugar de darte un único porcentaje sin matices, lo que facilita ver de dónde viene la sospecha. Mi pequeña reserva es que se vuelve inestable con textos muy cortos, así que una introducción reescrita y analizada por separado puede mostrar más variación que ese mismo texto dentro del borrador completo. En cuanto a la idea de @techpanda8363one de comparar ediciones equivalentes, eso es un argumento a favor de mantener intacto todo el documento y variar solo ese párrafo; de lo contrario, en parte estás midiendo la longitud, no la edición.
Decide qué haría falta para dar por válido un texto marcado como sospechoso antes de empezar a usar Copyleaks para revisar las entregas. Las etiquetas de permitido/no permitido de @omeganinja6093 ayudan, pero tendría reservas sobre adoptar un proceso en el que una alerta solo pueda impugnarse presentando borradores que nunca pediste a los colaboradores que conservaran. Como normalmente recibes el texto final, prueba a someter una entrega permitida al proceso de revisión como si hubiera sido marcada. Si no hay una forma realista de resolver ese caso sin exigir pruebas de su historial de redacción, yo pausaría la implementación, independientemente de lo bien que el detector evalúe tu introducción reescrita.